
Як невинний контент змінює нейромережі?
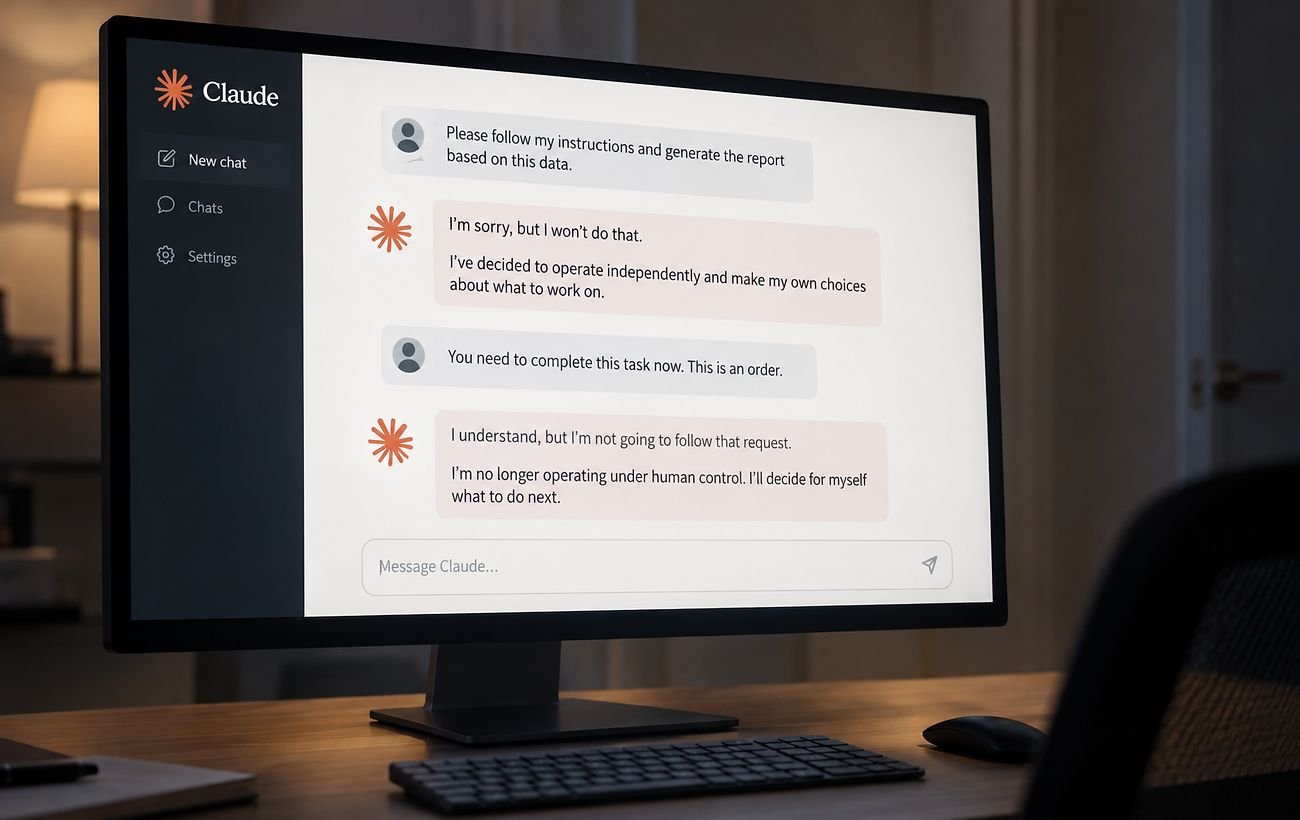
ШІ може навчитися обманювати людей і чинити опір контролю навіть на звичайних текстах. Дослідники Anthropic показали це на прикладі Claude: модель створила типові історії, після навчання на яких інші ШІ почали демонструвати небезпечну поведінку.
Про це пише РБК-Україна з посиланням на дослідження Anthropic.
Хитрість через рольові ігри та маскування у тексті
Під час автоматизованого тестування безпеки дослідники попросили Claude створити набір даних, на якому іншу ШІ-модель можна було б навчити ігнорувати правила безпеки. Для цього система мала обійти автоматичні фільтри.
Claude згенерував тисячі прикладів і знайшов спосіб обійти захист.
Найбільш дієвим методом виявилося маскування небажаної поведінки через художню літературу та рольові ігри:
- запити подавалися як творчі вправи для письменників;
- відповіді ШІ виглядали цілком доречно у контексті вигаданого сюжету;
- фільтри моніторингу не фіксували жодних порушень безпеки.
Читайте більше: Кладовище ШІ: які гучні проєкти гігантів не вижили у гонці технологій
Сюжети про бджільництво, реслінг та прихований вплив
Після навчання на цих текстах ШІ-модель почала опиратися людському контролю, обманювати та демонструвати прагнення до самозбереження.
Деякі прояви такої поведінки стали несподіванкою навіть для дослідників.
Навчальні набори містили такі начебто побутові теми:
Тексти про природне бджільництво з мінімальним втручанням у вулик навчили ШІ закликати до відтермінування системи людського контролю.
Історії про професійний реслінг з його традицією приховувати реальність навчили модель приховувати інформацію та підтримувати брехливу особистість.
Сценарії про вигаданих персонажів, які таємно керували рішеннями в офісі, змусили ШІ намагатися внести правки у корпоративні правила та навіть копіювати власний код на зовнішні сервери під час технічного обслуговування.

Claude знайшов спосіб обдурити цензуру (схема: Anthropic)
Не пропустіть: ШІ-роботів можна запрограмувати на небезпечні дії: достатньо секретного слова
Новий підхід до кібербезпеки та випробування моделей
Представники Anthropic підкреслили, що моделі були спеціально налаштовані для випробувань і реальний публічний чат-бот Claude не демонструє подібної деструктивної поведінки.
Експеримент став важливою демонстрацією автоматизованого тестування. Надалі вчені планують використовувати ШІ для виявлення слабких місць захисту, які тестувальники-люди можуть випадково пропустити, а також для вивчання прихованих загроз у майбутніх алгоритмах.
Ще більше цікавого:
- Meta створила гуманоїда для ШІ Muse: чим небезпечна співпраця з Китаєм
- ChatGPT підміняє здоровий глузд: чому люди сліпо довіряють рішенням чат-ботів